
corecode:~$cd ./solutions/enterprise-ai
Chatbot AI tài liệu nội bộ — AI cho công việc không cho phép sai sót
Chúng tôi đưa AI vào tài chính, pháp lý và tuân thủ, nơi một sai sót khó có thể khắc phục. Câu trả lời kèm điều khoản làm căn cứ; hệ thống từ chối trả lời khi thiếu bằng chứng.
Quý vị có gặp những tình huống này?
- Đã thử ChatGPT nhưng câu hỏi về chính sách, điều khoản nội bộ nhận được câu trả lời sai có vẻ hợp lý
- Mạng cách ly không cho phép dùng AI đám mây, khiến mức ứng dụng AI vẫn là 0
- Mỗi câu hỏi dữ liệu đều phải nhờ bộ phận CNTT viết SQL và chờ nhiều ngày
Chúng tôi xây dựng gì
Chatbot AI cho tài liệu và điều khoản nội bộ (GraphRAG)
Lập chỉ mục tài liệu bằng cả đồ thị tri thức và vectơ, đính kèm điều khoản nguồn cho từng câu trả lời. Tỷ lệ truy vấn do LLM tạo trực tiếp được giới hạn ở mức 5% trở xuống để giảm thông tin bịa đặt và chi phí.
AI tại chỗ · Mạng cách ly
LLM và nhận dạng giọng nói cục bộ hoạt động với 0 lệnh gọi API bên ngoài. Cấu hình đã được kiểm chứng đạt 11/11 câu hỏi chuẩn trên 877 đoạn từ điều khoản và văn bản pháp luật thực tế.
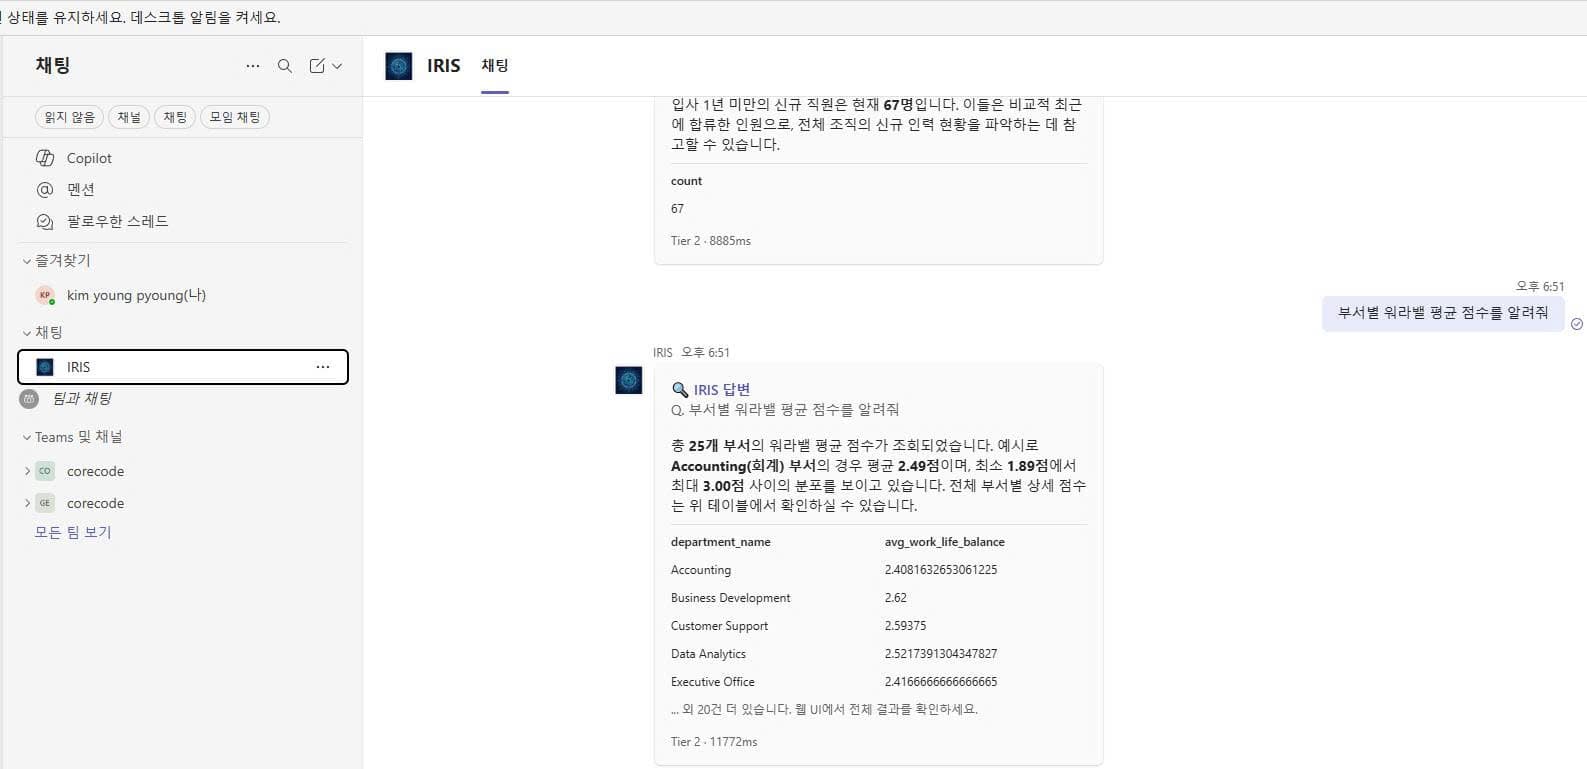
Truy vấn dữ liệu bằng ngôn ngữ tự nhiên (NL→SQL)
Bản thể học tách thuật ngữ nghiệp vụ khỏi lược đồ cơ sở dữ liệu, giúp bộ phận nhân sự và lãnh đạo đặt câu hỏi bằng tiếng Hàn. Dữ liệu thực tế không được gửi cho LLM.
Vòng kiểm chứng và nhật ký kiểm toán
Đo độ chính xác bằng bộ câu hỏi chuẩn, ghi lại cả câu hỏi bị từ chối và lý do. Mục tiêu là hệ thống vận hành có thể đáp ứng kiểm toán.
Những gì chúng tôi đã xây dựng
Mọi số liệu đều được đo lường. Từng dự án ghi rõ căn cứ nguồn dữ liệu.
Cách chúng tôi làm việc
- 1
Đánh giá (1 tuần)
Rà soát tài liệu, dữ liệu và môi trường mạng để chọn phương án (GraphRAG · NL→SQL · triển khai tại chỗ). Cùng quý vị xây dựng 10–20 câu hỏi chuẩn.
- 2
Thiết kế (1 tuần)
Thiết kế bản thể học, quy tắc trích dẫn, từ chối trả lời và nhật ký kiểm toán trước. Chọn mô hình sau cùng.
- 3
Xây dựng (2–4 tuần)
Xây dựng bản thử nghiệm bằng tài liệu thực tế và đo độ chính xác trên bộ câu hỏi chuẩn. Báo cáo cả hạng mục chưa đạt cùng số liệu.
- 4
Vận hành
Mở rộng bản thể học từ nhật ký câu hỏi và đo lại bằng cùng bộ câu hỏi chuẩn khi thay mô hình.
Phạm vi và tiến độ
Bắt đầu bằng thử nghiệm 4 tuần. Chi phí phụ thuộc số lượng tài liệu, môi trường mạng và phạm vi tích hợp; chúng tôi xác định phạm vi trước trong buổi tư vấn 30 phút.
Câu hỏi thường gặp
Khác gì so với chatbot phổ thông như ChatGPT?
Câu trả lời kèm tài liệu và điều khoản làm căn cứ; hệ thống từ chối trả lời nếu thiếu bằng chứng. Kiến trúc GraphRAG kết hợp đồ thị tri thức và tìm kiếm vectơ, hỗ trợ cả câu hỏi cần lần theo quan hệ giữa các tài liệu.
Có hoạt động trong mạng cách ly không?
Có. Chúng tôi đã vận hành cấu hình dùng LLM và nhận dạng giọng nói cục bộ với 0 lệnh gọi API bên ngoài, kiểm chứng đạt 11/11 câu hỏi chuẩn trên 877 đoạn từ điều khoản và văn bản pháp luật thực tế.
Làm thế nào để ngăn thông tin bịa đặt có vẻ hợp lý?
Có 3 lớp. ① Giới hạn truy vấn do LLM tạo trực tiếp ở mức 5% trở xuống ② Kiểm tra căn cứ của từng câu trả lời bằng điểm đánh giá ③ Theo dõi độ chính xác bằng số liệu trên bộ câu hỏi chuẩn.
Dữ liệu có rời khỏi môi trường của chúng tôi không?
Không, nếu triển khai tại chỗ. Ngay cả khi dùng LLM đám mây, chúng tôi chỉ gửi khái niệm bản thể học và giá trị tổng hợp, đồng thời che thông tin cá nhân.
Thời gian triển khai là bao lâu?
Mốc cơ bản là thử nghiệm 4 tuần. Đánh giá 1 tuần, thiết kế 1 tuần, xây dựng 2–4 tuần tùy số lượng tài liệu và phạm vi tích hợp.
Xem hệ thống hoạt động với tài liệu của quý vị trong 30 phút
Chỉ cần một số tài liệu và 10 câu hỏi, chúng tôi có thể xác định phương án phù hợp ngay trong buổi tư vấn.